新闻发布于:
百度开源 Unlimited OCR 2:上百页文档一次解析,免部署 API 限时免费
百度文心团队的 Unlimited OCR 2 用 SR-SWA 让超长文档解析的每步开销基本恒定,模型已开源,百度智能云也上线了限时免费的文档解析 API。
百度文心团队在10月27日发布了文档解析模型 Unlimited OCR 2,模型权重放在 Hugging Face 和魔搭社区。10月30日,百度智能云的文档解析接口说明也更新了,基于这个新模型的 API 现在可以直接调用,而且限时免费。
它解决的是什么问题
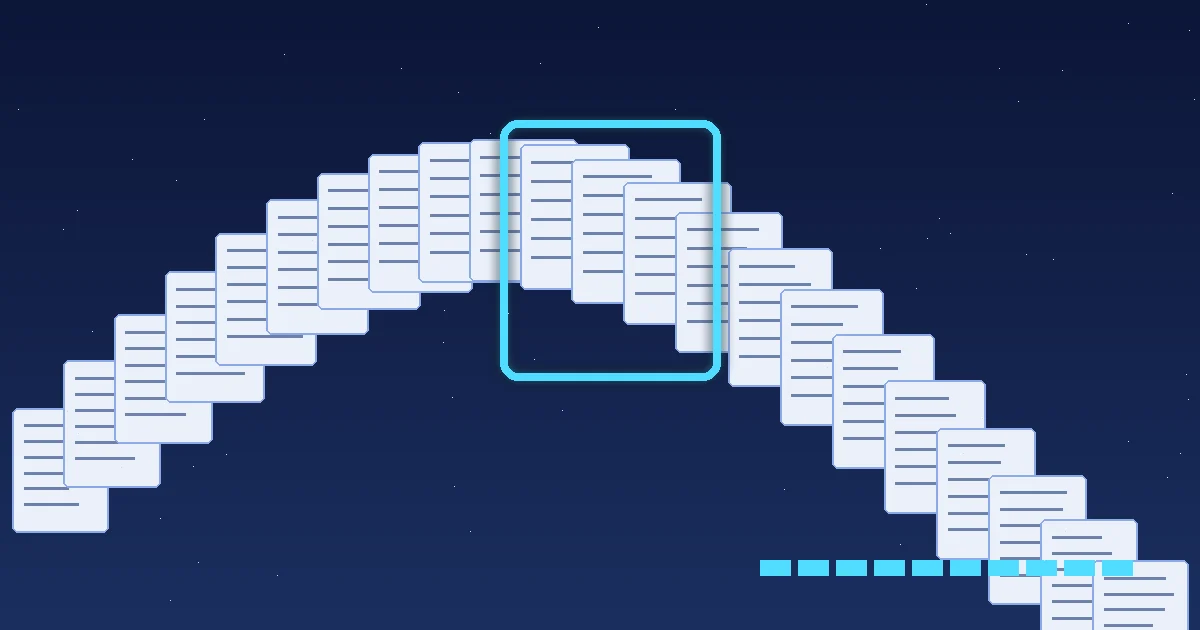
普通的 OCR 模型处理几十页、上百页的长文档时,越往后要「回头看」的内容越多,计算量和显存都会跟着涨。Unlimited OCR 2 的思路是像人抄书一样,只盯着正在转写的那一部分:解码器里的注意力换成了稀疏参考滑动窗口注意力(SR-SWA),把需要参考的视觉和文字信息压缩到一个固定大小的集合(例如512个 token),所以无论文档多长,每一步的延迟和内存占用都基本不变。
按照团队论文里的数据,在百页规模的文档上,它每一步的速度比全注意力快约7倍。团队还一起发布了专门测试百页级长文档解析的新基准 MarathonDocBench。
免部署 API 怎么用
- 能自动合并跨页的表格和段落,识别标题层级,直接输出 JSON 或 Markdown
- 异步接口:先提交任务拿到 task_id,再轮询结果,官方建议间隔5到10秒
- 个人实名认证可领200页免费测试额度,企业实名认证是1000页
我的看法
我平时整理设定集、访谈刊物的扫描件,最头疼的就是跨页表格被切成两半。一个能把整本文档一次读完、还保留结构的开源模型,对做资料整理的人很实用。想自己部署的可以用 Transformers 先试,正式使用官方推荐 SGLang。
来源: ai.baidu.com