新闻发布于:
商汤开源SenseNova-Loop-9B-Preview:中间24层循环跑两遍,90亿参数做出约146亿的推理深度
商汤10月30日以Apache 2.0协议开源多模态模型SenseNova-Loop-9B预览版,采用循环解码结构与混合注意力,训练上下文最长约26万token。
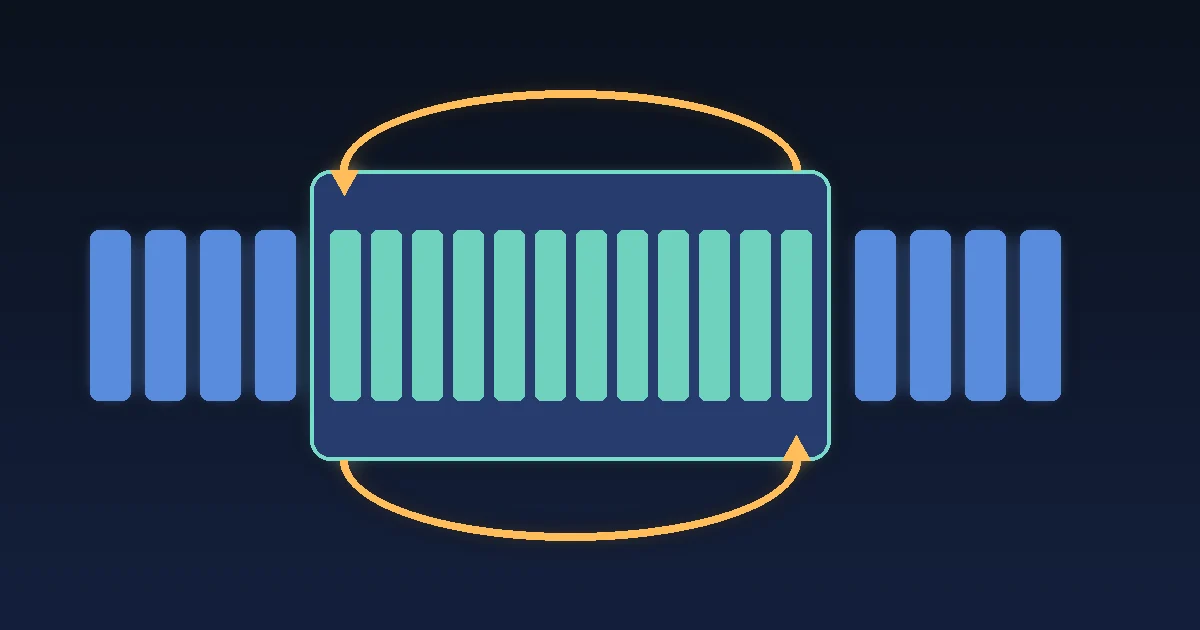
商汤在10月30日开源了一个结构上很有意思的模型:SenseNova-Loop-9B-Preview。模型以 Apache 2.0 协议发布,权重和说明见 Hugging Face模型页。
它“循环”在哪里
普通的大模型,每一层只算一次。这个模型一共32个不同的层,其中第4层到第27层这 24层会连续跑两遍,而且两遍共用同一套权重。这样算下来,一次推理要经过56层。
结果就是:模型总参数大约 90亿,但推理时的等效参数大约 146亿。存储和显存按小模型算,思考的“深度”却接近大一号的模型。
其他要点
- 多模态:可以输入文字和图片,输出文字。
- 混合注意力:线性注意力和完整注意力按四层一组交替排列,兼顾长文本效率和精度。
- 长上下文:训练时的上下文最长约 26.2万token。
- 连接方式:使用双流的mHC(流形约束超连接)来稳定层与层之间的信息传递。
- 加速:已支持MTP多token预测加速,另外两种加速方案还在训练中。技术报告目前还没发布。
我的看法
大家都在拼参数规模,商汤反过来问:同一批权重多用一次,能换来多少能力?对想在本地显卡上跑模型的人来说,这条路线很实际。
不过它名字里带着“Preview”,技术报告也还没出,循环两遍到底换来多少真实提升,还要等更完整的评测数据。
来源: huggingface.co