新闻发布于:
微信视觉团队开源WeVisOne-VL:一个模型搞定检测、计数、OCR、分割和抠图
腾讯微信开源视觉语言模型WeVisOne-VL,2B与4B两个版本,统一物体级与像素级感知,目标不存在时会直接拒答,Apache 2.0许可。
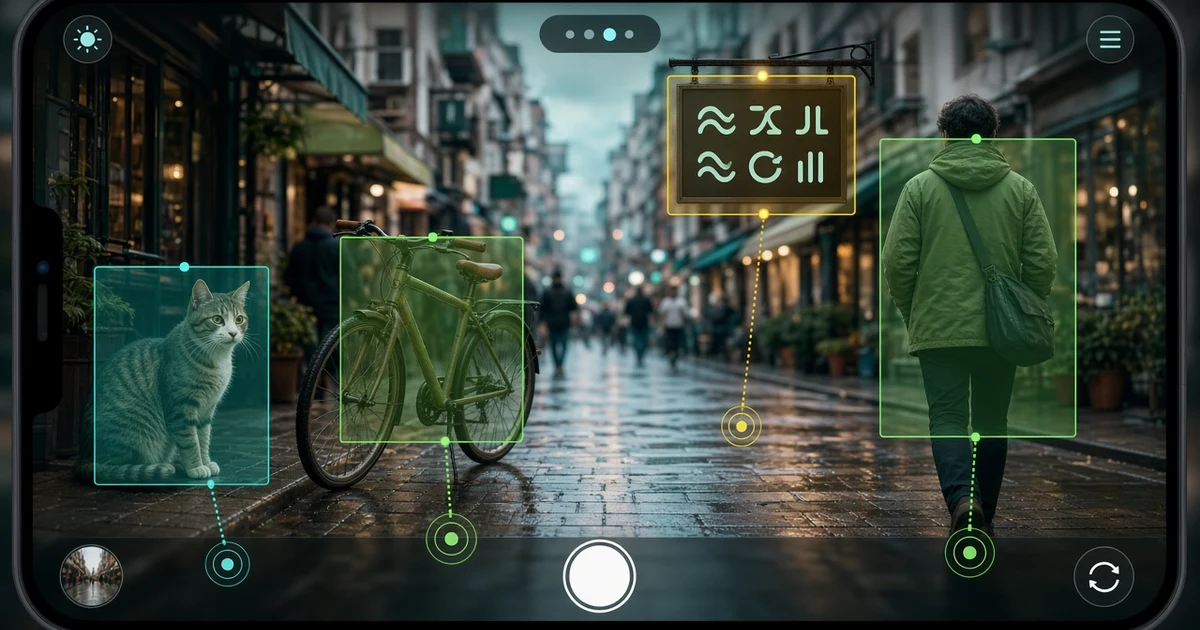
腾讯微信视觉团队开源了视觉语言模型 WeVisOne-VL(WeChat Vision All-in-One),在 GitHub 和 Hugging Face 上同时放出了 2B 和 4B 两个版本的权重,采用 Apache 2.0 许可。
它想解决什么问题
以往做视觉任务,检测、计数、OCR、分割、抠图往往要拼好几个专用模型。WeVisOne-VL 的思路是把这些都放进一个模型里:
- 物体级感知:目标检测、指代定位、计数、指点和 OCR,用结构化的下一个 token 预测来输出。
- 像素级感知:指代分割和可提示抠图,靠一个只有 960万参数 的轻量像素解码器输出遮罩和 alpha matte,不需要再接 SAM。
- 可靠拒答:问到图里不存在的东西时,模型会返回 None,而不是硬编一个框出来。
成绩怎么样
官方给出的对比里,4B 版本在 Dense200 密集检测上 F1 从基线的58.7提升到71.3,PixMo-Count 计数准确率89.6%,TotalText 文字识别 F1 为52.0。最亮眼的是拒答:在团队自建的 WeRef-Bench 上拒答率达到96.4%,而最强基线是73.0%。需要注意,这个测试集是团队自己做的,参考时要打点折扣。
除了权重,团队还放出了技术报告、推理包、Cookbook、评测流程和在线 Demo,并单独开源了数据管线里用来把二值遮罩转成高质量 alpha matte 的标注工具 Mask2Alpha。微调代码目前还在待办清单上。
我的看法
“不知道就说没有”这一点,比多涨几个点更实用。做相册搜索、商品识别这类功能时,模型乱框比漏框更伤体验。2B 体量也让端侧部署有了想象空间。
来源: github.com